GEO · Mitos
¿Sirve el llms.txt? Lo que el GEO no es.
Qué es el llms.txt
Es una propuesta de estándar, no oficial, publicada en llmstxt.org: un archivo de texto en la raíz de tu web (tuweb.com/llms.txt) con un resumen de tu sitio y enlaces a sus páginas más importantes, pensado para que un modelo de IA lo lea más fácil.
La idea suena bien. El problema es que una propuesta no obliga a nadie a usarla, y los que deciden qué webs recomienda la IA no se han comprometido a hacerlo.
Qué dice Google
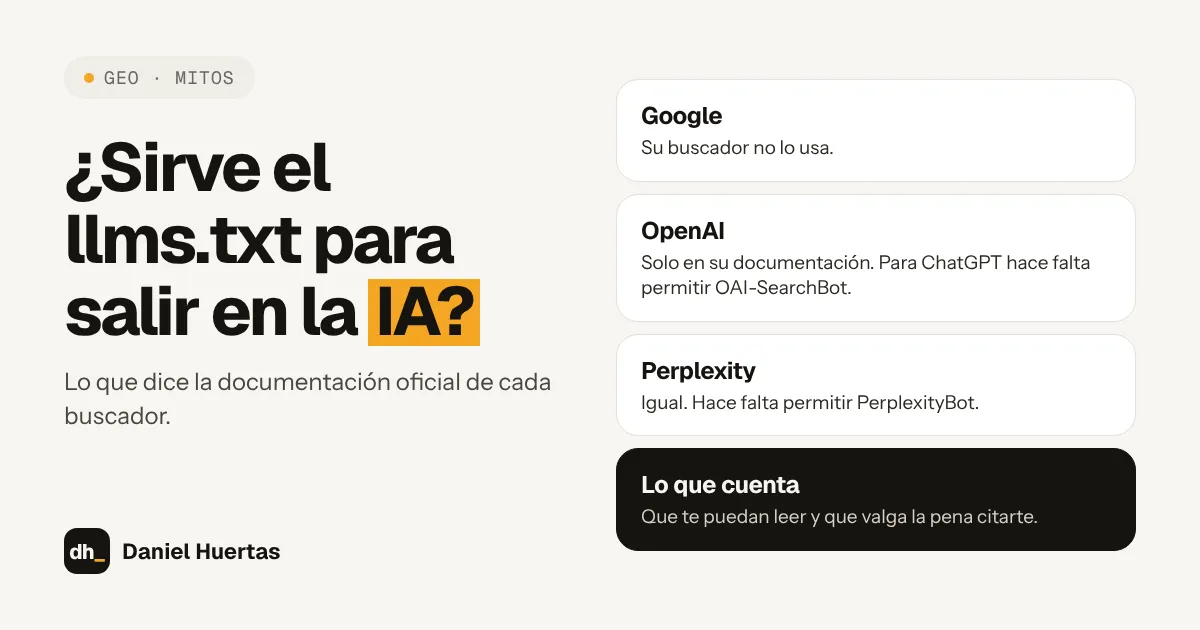
En su guía para la búsqueda con IA (actualizada en julio de 2026), Google lo dice sin rodeos: su buscador no usa el llms.txt ni otros archivos “especiales”, y añadirlo no cambia tu visibilidad ni tus posiciones, porque lo ignora.
Y va más allá: para Google, optimizar para su IA (AI Overviews y AI Mode) es hacer SEO. Sus respuestas con IA se construyen sobre su buscador normal: si tu página no está indexada y bien posicionada, no hay archivo que la meta en una respuesta.
¿Y ChatGPT o Perplexity?
Aquí hay un matiz que casi nadie cuenta. OpenAI y Perplexity sí publican un llms.txt, pero en su documentación para desarrolladores, para que las herramientas de programación la lean mejor. Eso no significa que lo usen para decidir qué negocios recomiendan.
En las páginas donde explican cómo rastrean la web, lo que piden es otra cosa: que permitas a sus rastreadores en tu robots.txt. En ChatGPT, el que decide si apareces en sus búsquedas es OAI-SearchBot; en Perplexity, PerplexityBot. Si los bloqueas en tu robots.txt, aunque sea por error, desapareces de sus respuestas. Y el llms.txt no aparece en ninguna de esas reglas.
| Buscador | llms.txt | Qué necesitas para poder aparecer |
|---|---|---|
| Su buscador lo ignora: ni te ayuda ni te perjudica. | Que tu página esté indexada y bien posicionada. | |
| OpenAI (ChatGPT) | Lo publica en su documentación para desarrolladores. | OAI-SearchBot, si lo permites en tu robots.txt. |
| Perplexity | Lo publica en su documentación para desarrolladores. | PerplexityBot, si lo permites en tu robots.txt. |
¿Y por qué lo revisa PageSpeed Insights?
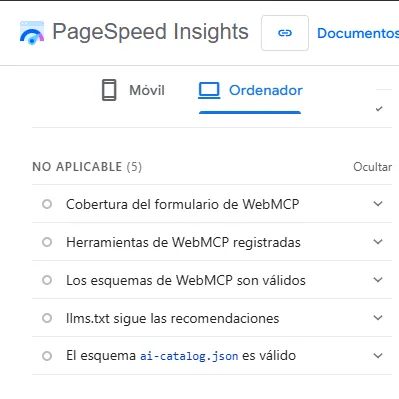
Desde mayo de 2026, Lighthouse (el motor de PageSpeed Insights) tiene una categoría experimental llamada Navegación agéntica. Comprueba si la web está preparada para que la usen agentes de IA, que navegan, leen y rellenan formularios por el usuario. Una de sus comprobaciones es el llms.txt.
Conviene saber tres cosas:
- Mide la preparación para agentes, no la visibilidad en Google ni en ChatGPT. Google sigue diciendo que para Search no hace falta.
- No tenerlo no penaliza. Si tu web no tiene llms.txt, la auditoría aparece como «No aplicable». Solo falla si lo tienes y está mal hecho: sin título H1, demasiado corto o sin enlaces en formato Markdown.
- Es experimental, se basa en estándares propuestos y no da una nota de 0 a 100, sino cuántas comprobaciones superas.
Lo comprobé en esta misma web, que no tiene llms.txt: la categoría sale 2/2 y la auditoría del llms.txt aparece como «No aplicable» (PageSpeed Insights, 19 de octubre de 2026).
Mi conclusión: si lo vas a mantener actualizado, créalo bien hecho, porque no cuesta nada y ayuda a los agentes. Pero no esperes que te haga aparecer en las respuestas de la IA.
Lo que el GEO no es
El llms.txt es el mito más vendido, pero no el único. Estos son los que Google desmiente en su propia guía:
- Un archivo mágico. Ni llms.txt ni marcado “especial” para la IA.
- Trocear tus textos en piezas pequeñas. Google entiende páginas con varios temas y no hay una longitud ideal.
- Reescribir tu web “para robots”. No hace falta escribir de una forma especial para la IA ni cubrir cada variante de una pregunta.
- Un schema secreto. Los datos estructurados no son obligatorios para la IA y no existe un marcado especial. Siguen siendo útiles, pero para otras cosas (resultados enriquecidos).
- Comprar menciones. Buscar menciones artificiales en otras webs no ayuda: los sistemas de calidad de Google las filtran.
- Una página por cada pregunta. Crear decenas de páginas casi iguales para cada forma de preguntar es lo que Google llama abuso de contenido a escala, y es spam.
Lo que sí funciona
Lo que Google sí recomienda es menos llamativo, pero es lo que mueve la aguja:
- Contenido que no está en otras webs: tu experiencia, tus casos, tu punto de vista. Es lo que más pesará a largo plazo, según Google.
- Dejar entrar a quien tiene que entrar. Permitir en el robots.txt los rastreadores de búsqueda de cada IA (OAI-SearchBot, PerplexityBot, Claude-SearchBot…) y comprobar que tu CDN o tu cortafuegos no los bloquea por defecto. Es un fallo frecuente: una web puede quedarse fuera de la IA sin que su dueño lo sepa.
- Una web que se lea bien: lo importante en texto (no dentro de imágenes), buena estructura de encabezados y enlaces internos claros.
- Tu ficha de Google Business Profile al día, si tienes un negocio local.
- Medir: Search Console ya tiene un informe de rendimiento de las funciones de IA de Google.
Lo que me he encontrado en webs reales
Cuando llevaba el marketing de varias clínicas y de un despacho, me preguntaron cómo salir en ChatGPT. Mi respuesta fue la misma que hoy: la IA tiende a recomendar a quien demuestra autoridad. Datos propios, pruebas reales y contenido que resuelve lo que tu cliente quiere saber. Un texto genérico lleno de palabras clave no conecta con nadie, tampoco con una IA.
Uno de los fallos que me he encontrado no tenía nada que ver con el contenido: un CDN como Cloudflare, configurado por seguridad, bloqueaba a los rastreadores. La web estaba bien hecha, pero para la IA era invisible. Ningún llms.txt lo habría arreglado; una regla de configuración, sí.
En esta web no hay llms.txt. Su robots.txt permite los rastreadores de búsqueda y de usuario de ChatGPT, Perplexity, Claude y Apple, que son los que dan visibilidad. Los de entrenamiento (los que usan el contenido para entrenar modelos) son una decisión de negocio distinta; hoy también los dejo pasar.
Cómo evaluar un servicio de GEO sin ser experto
Busca “optimización para ChatGPT” y encontrarás de todo: herramientas que miden cómo aparece tu marca en la IA (útiles para medir), generadores gratuitos de llms.txt y artículos con cifras como “tres veces más probable que te citen” sin decir de dónde salen. Antes de pagar por “GEO”, pregunta tres cosas:
- ¿Qué fuente oficial respalda esto? Si la respuesta es “lo dice todo el mundo”, o una cifra sin estudio detrás, desconfía.
- ¿Me garantizas que ChatGPT me va a recomendar? Nadie puede garantizarlo. Lo que responde una IA no lo controla nadie, tampoco yo.
- ¿Qué vas a cambiar en mi web y cómo lo vamos a medir? Si el plan cabe en “subir un archivo”, no es un plan.
Preguntas frecuentes
¿Poner un llms.txt perjudica mi web?
No. Google dice que lo ignora, así que ni suma ni resta en su buscador. El problema no es el archivo, sino pagar por él pensando que es lo que te hará aparecer en la IA.
¿Es lo mismo llms.txt que robots.txt?
No. El robots.txt es un estándar que los rastreadores respetan y sirve para dejarlos entrar o no. El llms.txt es una propuesta para resumir tu web a una IA, sin compromiso de uso por parte de los buscadores. Si tienes que revisar uno, revisa el robots.txt.
¿Debo bloquear GPTBot?
GPTBot solo rastrea para entrenar los modelos de OpenAI; bloquearlo no te saca de las búsquedas de ChatGPT, que dependen de OAI-SearchBot. Es una decisión de negocio: si no quieres que tu contenido entrene modelos, bloquéalo; si te da igual, puedes dejarlo pasar.
¿Quieres saber qué dice la IA de tu negocio?
Lo compruebo a mano en ChatGPT, Perplexity y Gemini con la pregunta que haría tu cliente. Te respondo en 24 h laborables y en 48 h tienes el vídeo con lo que responden, si apareces y tres mejoras concretas.
Fuentes
- Google Search Central, «Optimizing your website for generative AI features on Google Search» (actualizada el 10 de julio de 2026)(se abre en una pestaña nueva). Consultada el .
- Google Search Central, «AI features and your website»(se abre en una pestaña nueva). Consultada el .
- OpenAI, «Overview of OpenAI Crawlers»(se abre en una pestaña nueva). Consultada el .
- Perplexity, «Perplexity Crawlers»(se abre en una pestaña nueva). Consultada el .
- Propuesta llms.txt(se abre en una pestaña nueva). Consultada el .
- Chrome for Developers, «llms.txt» (Lighthouse)(se abre en una pestaña nueva). Consultada el .
- Chrome for Developers, «Lighthouse agentic browsing scoring»(se abre en una pestaña nueva). Consultada el .